TEL-420 Sistemas Paralelos Módulo M4 · CUDA y GPGPU

Computación Paralela Masiva en GPU (CUDA)

Módulo M4 de la asignatura. Diseñado conforme al apartado 20 del programa docente oficial.

EC4 Semanas 11-13 12 horas 22 % de la nota Contenido completo

Introducción del módulo

En los módulos anteriores se estudió el paralelismo en procesadores de propósito general (CPU): paralelismo de memoria compartida con múltiples hilos en OpenMP (M2) y paralelismo en memoria distribuida coordinando nodos independientes mediante paso de mensajes con MPI (M3). Sin embargo, las CPUs modernas están arquitectónicamente optimizadas para minimizar la latencia de ejecución de secuencias de instrucciones complejas e impredecibles, dedicando la mayor parte de su superficie de silicio a enormes memorias caché (L1, L2, L3), unidades sofisticadas de predicción de saltos branch prediction y ejecución especulativa y fuera de orden (Out-of-Order Execution).

Por contraste, las unidades de procesamiento gráfico (GPU, Graphics Processing Units) evolucionaron siguiendo una filosofía diametralmente opuesta: maximizar el ancho de banda y la tasa de procesamiento global (throughput). En lugar de unos pocos núcleos veloces y complejos, una GPU integra miles de unidades de procesamiento aritmético más sencillas trabajando al unísono sobre inmensos volúmenes de datos homogéneos. Este paradigma, denominado GPGPU (General-Purpose computing on Graphics Processing Units), transformó la supercomputación contemporánea y es el pilar de la inteligencia artificial, el aprendizaje profundo, la visión computacional y las simulaciones científicas de alta fidelidad.

En este módulo se estudia la arquitectura y el modelo de programación de CUDA (Compute Unified Device Architecture), la plataforma líder creada por NVIDIA para explotar el paralelismo masivo en GPUs utilizando extensiones directas del lenguaje C/C++.

Competencia que se desarrolla (EC4). Diseñar e implementar soluciones de cómputo de alto rendimiento en arquitecturas masivamente paralelas basadas en GPU mediante el modelo de programación CUDA, optimizando el uso de la jerarquía de memoria, la configuración de hilos y la transferencia de datos entre el host y el device.


4.1 De procesadores vectoriales a GPU modernas

4.1.1 Evolución histórica: Del pipeline de renderizado fijo al cómputo de propósito general

A principios de la década de 1990, las tarjetas gráficas eran aceleradores 2D y rasterizadores sencillos. Con la llegada de los videojuegos 3D, surgieron chips con canalizaciones de funciones fijas (fixed-function pipeline): transformaciones geométricas, iluminación, proyección y mapeo de texturas realizables únicamente según algoritmos cableados en silicio.

A comienzos de los años 2000, los estándares OpenGL y DirectX introdujeron la programabilidad mediante sombreadores (shaders): pequeños programas ejecutables sobre vértices (vertex shaders) y píxeles (pixel shaders). Investigadores visionarios notaron que los cálculos matriciales y operaciones en punto flotante de los shaders podían mapearse a ecuaciones diferenciales, procesamiento de señales y álgebra lineal, acuñando el término GPGPU. No obstante, obligar al algoritmo a vestirse de triángulo y textura resultaba arduo y propenso a errores.

La revolución definitiva se consolidó en 2006 cuando NVIDIA presentó la arquitectura G80 (GeForce 8800 GTX) y lanzó CUDA. Por primera vez se unificaron las unidades de procesamiento en procesadores escalares programables de propósito general, permitiendo a los ingenieros escribir código C/C++ directamente sin ninguna metáfora gráfica.

4.1.2 Filosofía de diseño: CPU (Latencia) frente a GPU (Throughput)

La diferencia fundamental entre una CPU y una GPU radica en la asignación del área del chip de silicio:

Componente de silicioCPU (Multinúcleo clásico)GPU (Acelerador masivo)
ALUs (Unidades aritmético-lógicas)Moderadas (8 a 64 núcleos de alto rendimiento)Masivas (miles de CUDA cores y Tensor cores)
Caché y memoria localEnorme fracción del chip (decenas de MB en L2/L3)Reducida por núcleo; prioriza buffers y registros
Control de flujo y ejecuciónPredicción de saltos agresiva, ejecución fuera de ordenControl simplificado; múltiples núcleos comparten control
Objetivo primarioMinimizar latencia de un hilo individualMaximizar throughput total de millones de operaciones
Ancho de banda de memoria50 - 150 \text{ GB/s} (DDR4 / DDR5)1.000 - 3.300 \text{ GB/s} (GDDR6X / HBM2e / HBM3)

La CPU oculta la latencia de acceso a memoria principalmente mediante jerarquías de caché muy profundas y prebúsqueda (prefetching). La GPU, por el contrario, oculta la latencia mediante multithreading masivo: cuando un grupo de hilos se detiene esperando datos de la memoria global, la GPU conmuta instantáneamente a otro grupo de hilos listo para operar, sin penalización de ciclos de reloj.


4.2 Arquitectura CUDA: cores, bloques, grillas y jerarquía de memoria

4.2.1 El modelo Host-Device

En el modelo CUDA, el sistema computacional es heterogéneo:

  • Host (Anfitrión): La CPU convencional del sistema y su memoria principal del sistema operativo (RAM). Ejecuta el flujo secuencial, coordina entradas/salidas y prepara los datos.
  • Device (Dispositivo): La GPU aceleradora y su propia memoria de video dedicada (DRAM / VRAM). Ejecuta las funciones paralelas masivas denominadas kernels.
+--------------------------------------------------------+
|                     HOST (CPU)                         |
|  - Memoria RAM Principal                               |
|  - Control secuencial del programa                     |
|  - Invoca kernels: kernel<<<Grid, Block>>>(...)        |
+--------------------------------------------------------+
                           │
                 Bus PCIe / NVLink
                           │
+--------------------------------------------------------+
|                    DEVICE (GPU)                        |
|  - Memoria Global VRAM (GDDR6 / HBM)                   |
|  - Streaming Multiprocessors (SMs)                     |
|  - Miles de hilos organizados en Grillas y Bloques     |
+--------------------------------------------------------+

4.2.2 Jerarquía de hilos: Threads, Bloques y Grillas

Para gestionar millones de hilos de forma estructurada, CUDA organiza el espacio de ejecución en tres niveles:

  1. Thread (Hilo): La unidad elemental de ejecución. Cada hilo ejecuta la misma función kernel sobre datos diferentes según su identificador único.
  2. Block (Bloque de hilos): Un conjunto cooperativo de hilos que pueden compartir memoria compartida (shared memory) y sincronizarse mediante barreras. Un bloque puede tener 1, 2 o 3 dimensiones y contener típicamente hasta 1024 hilos.
  3. Grid (Grilla): El conjunto total de bloques lanzados para ejecutar un kernel. Puede ser 1D, 2D o 3D, permitiendo mapear directamente problemas físicos unidimensionales (vectores), bidimensionales (imágenes o matrices) y tridimensionales (volúmenes o mallas de fluidos).

4.2.3 Variables intrínsecas de indexación

Dentro del código de un kernel en C, cada hilo accede a variables predefinidas por el compilador para determinar su posición exacta:

  • threadIdx.{x, y, z}: Índice del hilo dentro de su bloque actual.
  • blockIdx.{x, y, z}: Índice del bloque dentro de la grilla.
  • blockDim.{x, y, z}: Dimensiones (cantidad de hilos) del bloque.
  • gridDim.{x, y, z}: Dimensiones (cantidad de bloques) de la grilla.

Para una grilla unidimensional, el índice global i se calcula como: $$i = \text{blockIdx.x} \cdot \text{blockDim.x} + \text{threadIdx.x}$$
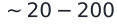
Para una matriz bidimensional (fila row, columna col): $$col = \text{blockIdx.x} \cdot \text{blockDim.x} + \text{threadIdx.x}$$ $$row = \text{blockIdx.y} \cdot \text{blockDim.y} + \text{threadIdx.y}$$
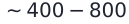

4.3 Modelo SIMT y ejecución en warps

4.3.1 Arquitectura física: El Streaming Multiprocessor (SM)

Una GPU moderna está compuesta por un conjunto de procesadores independientes denominados Streaming Multiprocessors (SM). Cada SM contiene:

  • Numerosas unidades de cómputo en punto flotante y enteros (FP32, FP64, INT32).
  • Unidades de funciones especiales (SFU: seno, coseno, raíz cuadrada).
  • Unidades matriciales especializadas (Tensor Cores en arquitecturas Volta, Ampere, Ada y Hopper).
  • Un gran archivo de registros de alta velocidad (Register File, típicamente 64K registros de 32 bits por SM).
  • Memoria compartida configurable / caché de nivel 1 (L1).
  • Programadores de warps (Warp Schedulers).

4.3.2 El concepto de SIMT (Single Instruction, Multiple Threads)

A nivel de hardware, los hilos de un bloque se ejecutan agrupados en paquetes rígidos de 32 hilos denominados warps. El modelo SIMT es una evolución de SIMD:

  • Todos los 32 hilos de un warp ejecutan la misma instrucción en el mismo ciclo de reloj.
  • A diferencia de SIMD (donde un único registro vectorial maneja varios escalares), en SIMT cada hilo tiene su propio conjunto de registros privados, su propio puntero de instrucción y su estado de ejecución.

4.3.3 Divergencia de Warps (Warp Divergence)

Si el código del kernel contiene una bifurcación condicional (if-else) donde algunos hilos del warp toman la rama verdadera y otros la falsa:

  1. El hardware no puede bifurcar los 32 núcleos a caminos independientes simultáneamente.
  2. La GPU serializa las dos ramas: primero ejecuta la rama if mientras los hilos del else se desactivan mediante una máscara; a continuación ejecuta la rama else mientras los hilos del if quedan inactivos.
  3. La divergencia reduce dramáticamente la eficiencia y el rendimiento del hardware. Regla de optimización: estructurar los datos y los algoritmos para que todos los hilos contiguos de un mismo warp sigan caminos de ejecución idénticos.

4.4 Programación de kernels CUDA en C/C++

4.4.1 Calificadores de función y variables

CUDA extiende la sintaxis estándar de C/C++ mediante calificadores especiales:

  • __global__ void miKernel(...): Declara una función que se ejecuta en el Device (GPU) y es invocada desde el Host (CPU). Debe retornar obligatoriamente void.
  • __device__ void miFuncionAux(...): Declara una función que se ejecuta en el Device y solo puede ser llamada por otra función que se ejecute en el Device.
  • __host__ void miFuncionHost(...): Función estándar ejecutable en la CPU (por defecto).

4.4.2 Ejemplo canónico: Suma de vectores en C/CUDA

A continuación se ilustra el kernel completo para sumar dos vectores C = A + B:

#include <stdio.h>
#include <cuda_runtime.h>

// Definicion del kernel en la GPU
__global__ void vectorAdd(const float *A, const float *B, float *C, int numElements) {
    int i = blockDim.x * blockIdx.x + threadIdx.x;
    if (i < numElements) {
        C[i] = A[i] + B[i];
    }
}

// Macro para captura y diagnostico riguroso de errores de la API CUDA
#define CHECK_CUDA(call) { \
    cudaError_t err = call; \
    if (err != cudaSuccess) { \
        fprintf(stderr, "Error CUDA en %s:%d - %s\n", __FILE__, __LINE__, cudaGetErrorString(err)); \
        exit(EXIT_FAILURE); \
    } \
}

4.4.3 Sintaxis de configuración de ejecución <<<Grid, Block>>>

Para invocar el kernel desde el main() en el host:

int N = 10000000; // 10 millones de elementos
int hilosPorBloque = 256;
int bloquesPorGrilla = (N + hilosPorBloque - 1) / hilosPorBloque;

// Lanzamiento asincrono del kernel en la GPU
vectorAdd<<<bloquesPorGrilla, hilosPorBloque>>>(d_A, d_B, d_C, N);
CHECK_CUDA(cudaGetLastError()); // Capturar errores de lanzamiento
CHECK_CUDA(cudaDeviceSynchronize()); // Esperar finalizacion en el host

4.5 Transferencia de datos host ↔ device y pinned memory

4.5.1 Ciclo de vida de una aplicación CUDA

Cualquier flujo de cómputo en GPU sigue rigurosamente el siguiente ciclo:

  1. Reservar memoria en el Host (malloc).
  2. Reservar memoria en el Device (cudaMalloc).
  3. Copiar datos de entrada del Host al Device (cudaMemcpy con cudaMemcpyHostToDevice).
  4. Invocar el kernel (kernel<<<Grid, Block>>>(...)).
  5. Copiar los resultados del Device al Host (cudaMemcpy con cudaMemcpyDeviceToHost).
  6. Liberar la memoria en ambos extremos (free, cudaFree).

4.5.2 El cuello de botella del bus PCIe

La memoria global de la GPU tiene un ancho de banda altísimo (> 1.000 \text{ GB/s}), pero la transferencia entre la memoria RAM de la CPU y la VRAM de la GPU ocurre a través del bus PCI Express (PCIe 4.0 x16 ofrece un ancho de banda teórico máximo de solo 31.5 \text{ GB/s}; PCIe 5.0 x16 alcanza 63 \text{ GB/s}). Por la Ley de Amdahl, si una aplicación pasa el 70 % de su tiempo total transfiriendo datos a través del bus PCIe, la aceleración global máxima posible jamás superará 3.33\times, sin importar cuán rápida sea la GPU.
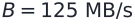
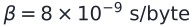
4.5.3 Memoria fijada (Pinned Memory) y transferencias asíncronas

La memoria reservada por defecto con malloc() en Linux es paginable. Cuando cudaMemcpy lee datos de memoria paginable, el driver de CUDA debe copiar primero los datos a un buffer intermedio fijado (pinned) antes de enviarlos por DMA (Direct Memory Access). Utilizando cudaMallocHost() se reserva memoria fijada directamente, logrando:

  • Hasta el doble de ancho de banda efectivo en transferencias PCIe.
  • Habilitación de transferencias asíncronas con cudaMemcpyAsync().
  • Capacidad de solapar computación en la GPU con transferencias de datos mediante CUDA Streams.

4.6 Optimización de memoria: global (coalescing), compartida y caché

4.6.1 Jerarquía de memoria en CUDA

CUDA ofrece múltiples tipos de memoria con distintas características de visibilidad, latencia y alcance:

Tipo de memoriaUbicación físicaAlcanceDuraciónLatencia relativa
Registros (Registers)En el SM (on-chip)Hilo individualCiclo del kernel\sim 1 ciclo
Memoria Compartida (Shared)En el SM (on-chip)Bloque de hilosCiclo del bloque\sim 1 - 5 ciclos
Caché L1 / L2En el SM / On-chipGlobal / SMPersistente\sim 20 - 200 ciclos
Memoria Global (VRAM)Fuera del chip (DRAM)Todos los hilos y HostPermanente\sim 400 - 800 ciclos
Memoria ConstanteCaché especializadaTodos los hilos (Read-only)Permanente\sim 1 ciclo (en hit)

4.6.2 Acceso coalescente a memoria global (Memory Coalescing)

La memoria global se lee en transacciones indivisibles de 32, 64 o 128 bytes alineados.

  • Acceso Coalescente: Cuando los 32 hilos de un warp acceden a direcciones de memoria consecutivas (ej. el hilo k accede al índice k), el hardware agrupa las 32 lecturas en una única transacción de memoria.
  • Acceso No Coalescente: Si los hilos acceden con un salto (stride) grande o de forma aleatoria, el hardware debe emitir hasta 32 transacciones separadas para servir a un solo warp, desperdiciando el 96 % del ancho de banda efectivo.

4.6.3 Uso de Memoria Compartida (Shared Memory)

La memoria compartida se declara con el calificador __shared__. Es extremadamente veloz y permite la colaboración entre hilos del mismo bloque. La técnica clásica es el Tiling (Teselado) para multiplicación matricial o convoluciones:

  1. Los hilos cargan colaborativamente una porción de la matriz grande desde la memoria global hacia una pequeña matriz en __shared__.
  2. Se sincronizan todos los hilos del bloque mediante __syncthreads().
  3. Todos los hilos realizan sus multiplicaciones leyendo de la memoria compartida a velocidad máxima sin tocar la lenta memoria global.
  4. Se repite el proceso para la siguiente tesela.

4.7 Análisis de rendimiento y factores limitantes

4.7.1 Ocupancia (Occupancy)

La ocupancia es el ratio entre el número de warps activos en un SM y el número máximo teórico de warps que el SM puede albergar simultáneamente: $$\text{Ocupancia} = \frac{\text{Warps activos}}{\text{Warps máximos soportados}}$$

Los tres recursos principales que limitan la ocupancia son:

  1. Uso de Registros por hilo: Si un kernel complejo consume 64 registros por hilo, el SM no podrá activar suficientes bloques simultáneos.
  2. Memoria Compartida por bloque: Si un bloque reserva 32 KB de shared memory y el SM dispone de 64 KB, solo 2 bloques podrán cohabitar en el SM.
  3. Tamaño del Bloque: Bloques con menos de 128 hilos o no múltiplos de 32 causan subutilización de los planificadores de warps.

4.7.2 Modelo Roofline para GPU

El rendimiento de una aplicación está limitado por dos techos infranqueables:

  • Límite de Ancho de Banda (Memory Bound): Operaciones simples con muchos accesos a memoria (como la suma de vectores). La métrica clave es la intensidad aritmética (FLOPs por byte transferido).
  • Límite de Capacidad de Cómputo (Compute Bound): Algoritmos densos con muchas operaciones aritméticas por cada dato leído (como GEMM o redes neuronales).

4.7.3 Herramientas de perfilado: NVIDIA Nsight Systems y Nsight Compute

  • Nsight Systems (nsys): Visualiza la cronología del sistema completo: uso de CPU, lanzamientos de kernels en GPU y transferencias PCIe en tiempo real.
  • Nsight Compute (ncu): Perfilado profundo a nivel de instrucciones del kernel: métricas de ocupancia, divergenica de warps, eficiencia de coalescing de memoria y análisis de cuellos de botella Roofline.

4.8 Casos de uso: álgebra lineal, imágenes e IA

4.8.1 Multiplicación de Matrices Generalizada (GEMM)

La operación matricial C = \alpha \cdot A \times B + \beta \cdot C es el núcleo algorítmico del aprendizaje profundo (Transformers, LLMs) y la mecánica computacional. Mientras que un algoritmo ingenuo en CPU O(N^3) rinde unos pocos GFLOPs, una implementación optimizada en CUDA con memoria compartida y Tensor Cores alcanza decenas de TFLOPs en GPUs modernas.

4.8.2 Procesamiento y filtrado masivo de imágenes

En visión artificial, las operaciones de convolución 2D (filtros Gaussianos, Sobel, detección de bordes) mapean cada píxel a un hilo independiente en una grilla 2D. El uso de memoria constante para los coeficientes del filtro y memoria compartida para los bordes del bloque acelera el procesamiento de video en tiempo real a cientos de cuadros por segundo en resolución 4K.

4.8.3 El ecosistema moderno de bibliotecas aceleradas

Para la práctica profesional en ingeniería, NVIDIA proporciona bibliotecas altamente optimizadas que superan habitualmente cualquier código manual:

  • cuBLAS / cuSPARSE: Álgebra lineal densa y dispersa.
  • cuFFT: Transformada rápida de Fourier paralela.
  • cuDNN: Primitivas optimizadas para redes neuronales profundas (convoluciones, activaciones, atención).
  • Thrust: Biblioteca de plantillas C++ de alto nivel (ordenamiento, reducciones) inspirada en la STL.

Actividades de Aprendizaje Autónomo — Módulo 4 (EC4)

Asignatura: TEL-420 · Sistemas Paralelos Módulo 4: Computación Paralela Masiva en GPU (CUDA) Docente: Ing. Elias Cassal Baldiviezo Horas de dedicación autónoma: 6 horas Semanas de ejecución: 11 a 13


1. Justificación y propósito pedagógico

Conforme al apartado 20.4 del Programa Docente del Proyecto Formativo, el trabajo autónomo en el módulo 4 permite al estudiante interiorizar la mentalidad de paralelismo masivo (Massively Parallel Processing), dominando la programación en GPU mediante la escritura de kernels de complejidad progresiva y el análisis crítico de la relación costo-beneficio de la aceleración por hardware.


2. Bloque de Actividades Autónomas Obligatorias

Actividad A1: Desarrollo de la serie de kernels CUDA de complejidad creciente

  • Momento de entrega: Fin de la Semana 12.
  • Instrumento de evaluación: file:///home/eliasdev/sistemas_paralelos/10-modulos/M4-cuda-gpgpu/rubrica-codigo-cuda.md (40% de EC4).
  • Consigna de trabajo:
  • Desarrollar e integrar en un repositorio GitHub la serie de 4 kernels CUDA:
  • Kernel 1: Operaciones vectoriales con cálculo de índices globales en 1D.
  • Kernel 2: Filtro 2D de suavizado de imágenes o cálculo de stencil con grilla bidimensional.
  • Kernel 3: Reducción paralela de suma en memoria compartida sin divergencia de warps.
  • Kernel 4: Multiplicación de matrices por bloques de teselas (Tiled GEMM) con memoria compartida.
  • Implementar comprobación automática de errores para cada llamada a la API CUDA mediante una macro en C (CHECK_CUDA_ERROR).
  • Validar los resultados frente a la CPU para matrices de al menos 2048 \times 2048.

Actividad A2: Estudio de literatura técnica oficial y análisis de código abierto

  • Momento de dedicación: Semanas 11 y 12.
  • Contenidos de estudio autónomo:
  • CUDA C++ Programming Guide (Capítulos 1 a 3: Modelo de programación y modelo de hardware).
  • CUDA C++ Best Practices Guide (Estrategias de optimización de memoria y ocupancia).
  • Inspección de repositorios de código abierto de bibliotecas aceleradas (cuBLAS, Thrust o CUDNN).

Actividad A3: Preparación del informe comparativo CPU vs GPU y análisis de ocupancia

  • Momento de entrega: Fin de la Semana 13.
  • Instrumentos de evaluación: file:///home/eliasdev/sistemas_paralelos/10-modulos/M4-cuda-gpgpu/rubrica-comparativo-cpu-gpu.md (30% de EC4) y file:///home/eliasdev/sistemas_paralelos/10-modulos/M4-cuda-gpgpu/rubrica-perfilado-gpu.md (30% de EC4).
  • Consigna de trabajo:
  • Ejecutar las herramientas de perfilado NVIDIA Nsight Compute sobre los kernels desarrollados.
  • Extraer capturas y métricas de ocupancia teórica vs alcanzada y porcentaje de coalescing de memoria global.
  • Redactar el informe técnico en PDF contrastando la aceleración obtenida frente a OpenMP en CPU y evaluando el coste de transferencia del bus PCIe.
M4

Diagnóstico

Examen HTML autocontenido interactivo.

M4

Sumativo

Examen HTML autocontenido interactivo.