P4a · Taller de escritura de kernels CUDA elementales y jerarquía de ejecución
1. Propósito y objetivos
Familiarizarse con el modelo de programación masivamente paralelo de NVIDIA CUDA en C/C++, comprendiendo la descomposición jerárquica de hilos (
2. Fundamentación técnica del modelo SIMT
La arquitectura de GPU se basa en el paradigma
2.1 Mapeo de índices globales
Para un vector unidimensional procesado por bloques de  hilos (
int idx = blockIdx.x * blockDim.x + threadIdx.x;Si el tamaño del vector  no es múltiplo exacto de
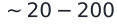 , la grilla debe dimensionarse con techo entero: $$G = \left\lceil \frac{N}{B} \right\rceil = \frac{N + B - 1}{B}$$ y dentro del kernel debe incluirse una condición de guarda obligatoria:
3. Ejercicios guiados
Ejercicio 1: Suma de vectores en GPU (vec_add.cu )
- Implementar el kernel con calificador
- Asignar memoria en host con
- Transferir los datos de host a device con
- Lanzar el kernel configurando
- Comprobar errores de lanzamiento con
- Transferir el resultado de vuelta al host con
Ejercicio 2: Producto punto / escalar de vectores
Implementar una versión preliminar de producto punto donde cada hilo calcula la multiplicación elemento a elemento
- Analizar por qué la reducción de la suma acumulada de todos los elementos representa un desafío en GPU y requiere sincronización a nivel de bloque (
4. Entregables
- Código fuente
- Reporte de verificación para
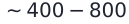 elementos comparando el tiempo de ejecución del kernel con el tiempo de la CPU.