P4b · Taller de optimización de transferencias Host-Device y memoria compartida
1. Propósito y objetivos
Dominar la jerarquía de memoria en arquitecturas GPU NVIDIA, diferenciando el acceso a memoria global de alta latencia (~400-800 ciclos de reloj) frente a la memoria compartida en chip (
2. Fundamentación técnica
2.1 Memoria Compartida (__shared__ )
La memoria compartida reside físicamente en cada multiprocesador de transmisión (
- Permite reutilizar datos leídos de la memoria global evitando lecturas repetitivas al bus DRAM.
- Requiere barreras de sincronización explícitas con
2.2 Reducción en árbol libre de divergencia de warps
Al sumar  elementos dentro de un bloque, una reducción inocente con
for (unsigned int s = blockDim.x / 2; s > 0; s >>= 1) {
    if (tid < s) {
        sdata[tid] += sdata[tid + s];
    }
    __syncthreads();
}
3. Ejercicios guiados
Ejercicio 1: Reducción paralela de suma con __shared__
- Escribir un kernel
- Implementar la reducción en árbol contigua para que el hilo 0 de cada bloque calcule la suma parcial de su bloque.
- El hilo 0 escribe el resultado parcial en un arreglo intermedio en memoria global.
- Medir la ganancia de velocidad frente a una reducción atómica global (
Ejercicio 2: Mediciones de tiempo de transferencia PCIe vs. Cómputo
Utilizando eventos de CUDA (
- Medir el tiempo invertido en
- Medir el tiempo puro de ejecución del kernel en GPU.
- Calcular la fracción del tiempo total absorbida por el bus PCIe. Comprobar experimentalmente por qué transferir arreglos pequeños destruye la ventaja de usar una GPU.
4. Entregables
- Código fuente
- Gráfica comparativa de tiempo total vs. tiempo de transferencia PCIe para tamaños de vector desde
 hasta
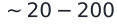 elementos.