P4c · Laboratorio de profiling con NVIDIA Nsight y comparativa de rendimiento CPU vs GPU
1. Propósito
Utilizar herramientas profesionales de análisis y perfilado de GPU (
2. Fundamentación analítica de GEMM
La multiplicación de matrices  de dimensión
 involucra
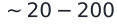 operaciones de punto flotante para
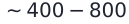 elementos de datos. Esta alta
2.1 Multiplicación por Bloques con Memoria Compartida (Tiled GEMM)
En lugar de que cada hilo lea su fila de  y columna de
 de la memoria global
 veces, los hilos de un bloque de
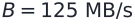 colaboran para cargar submatrices cuadradas en
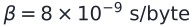 (típicamente
 o
 ).
3. Procedimiento experimental
Paso 1: Implementación de GEMM en GPU
- Kernel 1: Implementación elemental 2D (
 leyendo directamente de memoria global.
- Kernel 2: Implementación con particionamiento por teselas (
 hilos.
Paso 2: Perfilado con NVIDIA Nsight
Ejecutar la herramienta de línea de comandos para inspeccionar métricas de hardware:
# Perfilado de métricas de memoria y ocupancia
ncu --metrics sm__throughput.avg.pct_of_peak_sustained_elapsed,gpu__time_duration.sum ./gemm_tiled 2048- Analizar la métrica de ocupancia teórica vs. ocupancia lograda.
- Identificar si el factor limitante es el número de registros por hilo o la memoria compartida por bloque.
Paso 3: Comparativa cuantitativa CPU vs GPU
Comparar en una misma tabla los tiempos de ejecución para  :
- CPU Secuencial (
 ).
- CPU Paralelo con OpenMP en 8 núcleos (
 ).
- GPU Naive (
 ).
- GPU Tiled con memoria compartida (
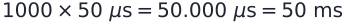 ).
4. Entregables
Informe técnico en PDF evaluado según la