P3b · Taller de operaciones colectivas y cálculo paralelo distribuido
1. Objetivo
Diseñar e implementar algoritmos paralelos en memoria distribuida empleando las rutinas de comunicación colectiva de MPI (
2. Requisitos previos
- Haber estudiado los apartados 3.4 y 3.5 del contenido del módulo 3.
- Comprender la diferencia entre operaciones uno-a-todos, todos-a-uno y todos-a-todos.
3. Ejercicios guiados
Ejercicio 1: Monte Carlo distribuido para aproximación de Pi
Implementar el cálculo estocástico de  :
- El proceso 0 recibe por línea de comandos el número total de dardos
 y lo difunde a todos los procesos mediante
- Cada proceso calcula su porción local de muestras:
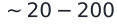 .
- Cada proceso cuenta cuántos puntos caen dentro del círculo unitario (
- Se agregan los aciertos locales mediante
- El proceso 0 calcula la aproximación final:
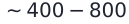 y mide el tiempo total de ejecución con
Ejercicio 2: Multiplicación de Matrices $C = A \times B$ distribuida
- El proceso 0 inicializa dos matrices densas cuadradas
 y
 de dimensión
 .
- Particionar
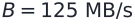 por filas contiguas: cada proceso recibe
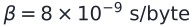 filas completas de
 mediante
- Transmitir la matriz
 completa a todos los procesos mediante
- Cada proceso calcula su bloque local de filas de la matriz resultante
 .
- Recombinar la matriz
 completa en el proceso 0 utilizando
- Validar numéricamente que el resultado coincide elemento a elemento con la versión secuencial con un margen
 .
4. Preguntas de reflexión técnica
- ¿Por qué es más eficiente
 llamadas a
- Si la matriz
 fuera demasiado grande para caber en la memoria de un solo nodo (
 ), ¿por qué falla este esquema y qué algoritmo alternativo se debe emplear (ej. Algoritmo de Cannon o Fox)?