P3a · Taller de paso de mensajes punto a punto y topología en anillo
1. Objetivo
Implementar, compilar y ejecutar aplicaciones paralelas en memoria distribuida mediante el estándar MPI en C, dominando el ciclo de vida del entorno (
2. Requisitos previos y verificación de entorno
- Haber estudiado los apartados 3.1, 3.2 y 3.3 de la unidad canónica de M3.
- Contar con
cat << 'EOF' > test_mpi.c
#include <mpi.h>
#include <stdio.h>
int main(int argc, char *argv[]) {
    int rank, size;
    MPI_Init(&argc, &argv);
    MPI_Comm_rank(MPI_COMM_WORLD, &rank);
    MPI_Comm_size(MPI_COMM_WORLD, &size);
    printf("Proceso %d de %d activo.\n", rank, size);
    MPI_Finalize();
    return 0;
}
EOF
mpicc test_mpi.c -o test_mpi && mpirun -np 4 ./test_mpi
3. Ejercicios guiados
Ejercicio 1: Paso de testigo en anillo (Token Ring ) bloqueante
Implementar un programa donde el proceso 0 genera un valor entero ( envía el valor de vuelta al proceso 0.
- El proceso 0 debe iniciar enviando antes de recibir para evitar un deadlock cíclico.
Ejercicio 2: Intercambio bidireccional y demostración de Deadlock
Escribir un código donde el proceso 0 y el proceso 1 intentan enviarse simultáneamente un arreglo masivo de  elementos) utilizando
- Observar cómo la ejecución se congela debido al agotamiento del búfer del protocolo Eager.
- Corregir el fallo utilizando
Ejercicio 3: Ocultamiento de latencia con comunicación no bloqueante
Modificar el programa de anillo para que el envío y la recepción se inicien con 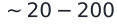 operaciones aritméticas flotantes). Medir con
4. Entregables
- Código fuente
- Breve reporte técnico respondiendo: ¿Por qué