P2c · Laboratorio de perfilado y análisis de rendimiento
1. Objetivo
Determinar, con datos medidos, dónde se va el tiempo en un programa paralelo; aplicar la Ley de Amdahl para interpretar el resultado; y justificar una única optimización con su efecto cuantificado.
2. Por qué esta práctica es distinta a las anteriores
En P2a y P2b el resultado era previsible:
3. Material de laboratorio
| Recurso | Alternativa si no está disponible |
|---|---|
| Intel VTune (gratuito) o TAU | |
| Code::Blocks / VS Code con terminal integrada | Cualquier editor con terminal |
| El comando |
Verifique la disponibilidad del perfilador antes de empezar:
perf --version || echo "perf no disponible: usar VTune"4. Desarrollo de la práctica
Paso 1: Programa de trabajo
/* Sistemas Paralelos - TEL420
 * Estudiante: NOMBRE COMPLETO
 * RU / CI: XXXXXXXX
 * Practica: P2c - Laboratorio de perfilado
 */
#include <stdio.h>
#include <stdlib.h>
#include <omp.h>
#include <math.h>

#define N 4000000

/* Norma: media y desviacion tipica. El calculo es trivialmente paralelizable,
 * pero el reparto secuente es enorme frente al calculo: buen caso para Amdahl. */
int main(void) {
    double *a = malloc(N * sizeof(double));
    for (int i = 0; i < N; i++) a[i] = (double)(i % 1000) / 1000.0;

    double t_relleno = omp_get_wtime();
    /* Reparto secuencial: el 90 % del trabajo real, aqui en serie */
    double suma = 0.0;
    for (int i = 0; i < N; i++) suma += a[i];
    double media = suma / N;
    double var = 0.0;
    for (int i = 0; i < N; i++) { double d = a[i] - media; var += d * d; }
    double desviacion = (var > 0) ? (double)sqrt(var / N) : 0.0;
    double t_secuencial = omp_get_wtime() - t_relleno;

    double t1 = omp_get_wtime();
    /* Calculo paralelo: lo que OpenMP puede acelerar */
    double suma2 = 0.0;
    #pragma omp parallel for reduction(+:suma2) schedule(static)
    for (int i = 0; i < N; i++) suma2 += a[i];
    double media2 = suma2 / N;
    double var2 = 0.0;
    #pragma omp parallel for reduction(+:var2) schedule(static)
    for (int i = 0; i < N; i++) { double d = a[i] - media2; var2 += d * d; }
    double desviacion2 = (var2 > 0) ? (double)sqrt(var2 / N) : 0.0;
    double t_paralelo = omp_get_wtime() - t1;

    printf("media       secuencial = %.6f   paralela = %.6f\n", media, media2);
    printf("desviacion  secuencial = %.6f   paralela = %.6f\n", desviacion, desviacion2);
    printf("tiempo reparto secuencial = %.4f s\n", t_secuencial);
    printf("tiempo calculo  paralelo = %.4f s\n", t_paralelo);
    return 0;
}
gcc -O2 -fopenmp -o perfilado perfilado.c -lm
./perfiladoPaso 2: Medición del tiempo según el número de hilos
for h in 1 2 4 8; do
  echo "--- $h hilos ---"
  OMP_NUM_THREADS=$h ./perfilado
done
Complete la tabla de  y
 para el cálculo paralelo.
Paso 3: Sesión de perfilado
# 1. Resumen de eventos de hardware
perf stat ./perfilado

# 2. Distribucion del tiempo entre funciones
perf record -g -- ./perfilado
perf report --stdio | head -40

# 3. Fallos de cache y ramas, que es lo que suele explicar la perdida de rendimiento
perf stat -e cache-misses,cache-references,branch-misses,branches ./perfilado
Con Intel VTune, el equivalente es
Paso 4: Verificación de la Ley de Amdahl
Con los datos medidos, calcule la fracción secuencial efectiva:
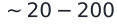
Despejando 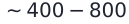 a partir del speedup medido
 y el número de hilos
 :

Simplificando, con 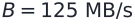 :
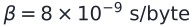
 calculado es muy superior al que usted esperaba, el perfilador tiene la respuesta de por qué.
Paso 5: Una única optimización
Elija
| Opción | Qué cambia |
|---|---|
| Paralelizar también el reparto | Eliminar la fase secuencial |
| Un solo bucle, sin segundo paso | |
| Fusión de los dos bucles | Recorrer los datos una sola vez |
| Cambiar la política de reparto |
Mida de nuevo con los mismos números de hilos y construya la tabla antes y después.
5. Evidencias requeridas
| N° | Evidencia | Contenido |
|---|---|---|
| 1 | Salida de | Terminal |
| 2 | Salida de | Terminal con los contadores de caché |
| 3 | Salida de | Terminal |
| 4 | Tabla de  y  y valor de  calculado | En el informe |
| 5 | Tabla comparativa antes y después de la optimización | En el informe |
| 6 | Perfilado en ejecución con | Captura de pantalla |
Las seis evidencias con la marca de personalización del apartado 4.2 de
6. Estructura del informe
Formato PDF,
| Sección | Contenido |
|---|---|
| 1. Portada | Datos institucionales, nombre, RU, fecha |
| 2. Metodología | Equipo, versión del compilador y del perfilador, procedimiento de medición |
| 3. Resultados previos | Tabla de tiempos,  y  antes de optimizar |
| 4. Perfilado | Distribución del tiempo, tasa de fallos de caché, interpretación |
| 5. Verificación de Amdahl | Cálculo de  y contraste con la medición |
| 6. Optimización | Qué se cambió, por qué, y efecto medido con la tabla antes/después |
| 7. Conclusiones | Si la optimización compensó el esfuerzo, con argumentos |
7. Criterios de evaluación
| Criterio | Descripción | Puntaje |
|---|---|---|
| Funcionamiento | Resultados numéricos idénticos entre la versión secuencial y la paralela | 15 |
| Perfilado | Se usó el perfilador y se interpretó su salida; no se resume solo el resultado | 25 |
| Análisis de Amdahl |  calculado correctamente y contrastado con los datos | 20 |
| Optimización | Una sola, justificada por el perfil y con efecto cuantificado | 25 |
| Comunicación técnica | Informe ordenado, tablas legibles, conclusiones apoyadas | 15 |
Rúbrica completa:
8. Preguntas de análisis
- ¿Qué parte del programa es la fracción secuencial
 de este ejercicio, y cuál es su peso real dentro del tiempo total?
- Si paralelizara el reparto secuencial, ¿qué valor alcanzaría la eficiencia? Calcule el nuevo
 y compárelo.
- ¿Qué parte del programa es
- ¿En qué momento del ciclo de optimización se encuentra este ejercicio, y cuál es la siguiente medición que haría?
- ¿Qué ocurriría si aumentara el número de hilos a 32 en una máquina de 8 núcleos físicos?