P2a · Taller de paralelización de bucles con la cláusula schedule
1. Objetivo
Aplicar
 y
 , y elegir la política de reparto en función del coste de la iteración y no por costumbre.
2. Requisitos previos
- Haber leído el apartado 2.4 del contenido del módulo.
- Tener el entorno de compilación con OpenMP disponible. Verificación rápida:
echo '#include <omp.h>
#include <stdio.h>
int main(void){ printf("hilos disponibles: %d\n", omp_get_max_threads()); return 0; }' > t.c
gcc -fopenmp t.c -o t && OMP_NUM_THREADS=4 ./t
Debe imprimir el número de hilos que haya fijado
3. Material de laboratorio
| Recurso | Detalle |
|---|---|
| Sistema operativo | Ubuntu 20.04 o superior, o Windows con WSL2 |
| Compilador | GCC con |
| CPU | Equipo del laboratorio (Dell OptiPlex, Intel Core i7) |
| Editor | Visual Studio Code con extensión C/C++ |
4. Desarrollo de la práctica
Paso 1: Programa secuencial de partida
Cree
/* Sistemas Paralelos - TEL420
 * Estudiante: NOMBRE COMPLETO
 * RU / CI: XXXXXXXX
 * Practica: P2a - Taller de scheduling con OpenMP
 */
#include <stdio.h>
#include <stdlib.h>
#include <time.h>

#define N 20000000

/* Coste de la iteracion i, irregular pero DETERMINISTA, para que las tres
 * versiones midan exactamente el mismo trabajo. */
static double coste(int i) {
    return (i % 97 == 0) ? 50.0 : 1.0;
}

int main(void) {
    struct timespec t0, t1;
    double suma = 0.0;

    /* Una de cada 97 iteraciones cuesta 50 veces mas: el reparto desequilibrado
     * se nota. Con un coste uniforme, cualquier politica daria lo mismo. */
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (int i = 0; i < N; i++) suma += coste(i);
    clock_gettime(CLOCK_MONOTONIC, &t1);

    double ts = (t1.tv_sec - t0.tv_sec) + 1e-9 * (t1.tv_nsec - t0.tv_nsec);
    printf("secuencial      : %.4f s   suma = %.1f\n", ts, suma);
    return 0;
}
Compile y ejecute para tener el valor de referencia 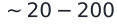 :
gcc -O2 suma_irregular.c -o suma_irregular
./suma_irregular
Paso 2: La versión paralela
/* Sistema: Paralelos - TEL420
 * Estudiante: NOMBRE COMPLETO
 * RU / CI: XXXXXXXX
 */
#include <stdio.h>
#include <time.h>
#include <omp.h>

#define N 20000000
static double coste(int i) { return (i % 97 == 0) ? 50.0 : 1.0; }

int main(void) {
    struct timespec t0, t1;
    double suma = 0.0;

    #pragma omp parallel for reduction(+:suma) schedule(static)
    for (int i = 0; i < N; i++) suma += coste(i);

    clock_gettime(CLOCK_MONOTONIC, &t0);
    #pragma omp parallel for reduction(+:suma) schedule(static)
    for (int i = 0; i < N; i++) suma += coste(i);
    clock_gettime(CLOCK_MONOTONIC, &t1);

    double tp = (t1.tv_sec - t0.tv_sec) + 1e-9 * (t1.tv_nsec - t0.tv_nsec);
    printf("paralelo static : %.4f s   suma = %.1f\n", tp, suma);
    return 0;
}Paso 3: Recorrido por las políticas
Cambie la cláusula
| Variante | Cláusula a probar |
|---|---|
| A | |
| B | |
| C | |
| D | |
| E | |
| F |
for h in 1 2 4 8 16; do
  echo "=== $h hilos ==="
  OMP_NUM_THREADS=$h ./suma_irregular
done
Paso 4: Sentido de identidad automático
Con
/* Sistema: Paralelos - TEL420
 * Estudiante: NOMBRE COMPLETO
 * Muestra que hilo procesa cada bloque de iteraciones */
#pragma omp parallel for schedule(static, 4)
for (int i = 0; i < 20; i++) {
    #pragma omp critical
    printf("iteracion %2d la tomo el hilo %d\n", i, omp_get_thread_num());
}
Repita cambiando
5. Evidencias requeridas
| N° | Evidencia | Cómo se toma |
|---|---|---|
| 1 | Salida de | Terminal |
| 2 | `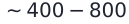 de la versión secuencial | Terminal |
| 3 | Tabla completa de tiempos para las 6 variantes y 5 números de hilos | Hoja de cálculo o tabla del informe |
| 4 | Salida del programa de identidad paralelo | Terminal |
| 5 | Diferencia de | Terminal, captura |
6. Estructura del informe
Formato PDF,
| Sección | Contenido |
|---|---|
| 1. Portada | Datos institucionales, materia, título, nombre completo, RU, fecha |
| 2. Marco | Qué se midió, con qué equipo y qué versión de compilador |
| 3. Resultados | Tabla de  ,  ,  y 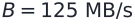 para cada variante |
| 4. Análisis | Gráfico de 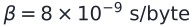 frente al número de hilos, una línea por política |
| 5. Conclusiones | Qué política conviene para un coste uniforme y para un coste irregular, con justificación |
7. Criterios de evaluación
| Criterio | Descripción | Puntaje |
|---|---|---|
| Funcionamiento | El programa compila y la suma coincide con la versión secuencial | 20 |
| Metodología de medición | Usa | 25 |
| Tabla de resultados | Completa: 6 variantes × 5 números de hilos, con  y  calculados | 20 |
| Análisis | Las conclusiones se desprenden de los datos, no de intuiciones | 20 |
| Autenticidad | Las 5 evidencias llevan la marca de personalización | 15 |
Rúbrica completa:
8. Preguntas de análisis
- Explique por qué
- La `
 ` de la mejor configuración, ¿supera el 100 %? Si es así, ¿es un error de medición?
- Si el
 , ¿qué pasaría?
- ¿En qué situación sería